
10 продвинутых SEO-терминов простыми словами для малого бизнеса
В советах по поиску полно сокращений. В презентации агентства мелькают языковые теги и «link equity», инструмент ругается на «crawl depth», подрядчик клянётся «SERP-фичами». Владельцу клиники, интернет-магазина или сервисной компании нужен понятный SEO-глоссарий, а не ещё один бесконечный how-to.
Ниже — словарь из 10 продвинутых SEO-терминов простыми словами. У каждого термина: короткое определение, зачем это владельцу малого бизнеса и одно практическое правило. Это не календарь работ и не рейтинг тактик. Когда нужно выбрать, какие SEO-задачи ставить в приоритет, откройте тот гайд. Когда клиенты ищут «рядом» и нужны бесплатные шаги для локального поиска, держите это отдельным слоем. Когда словарь пора превратить в календарь, возьмите расписание SEO по неделям.
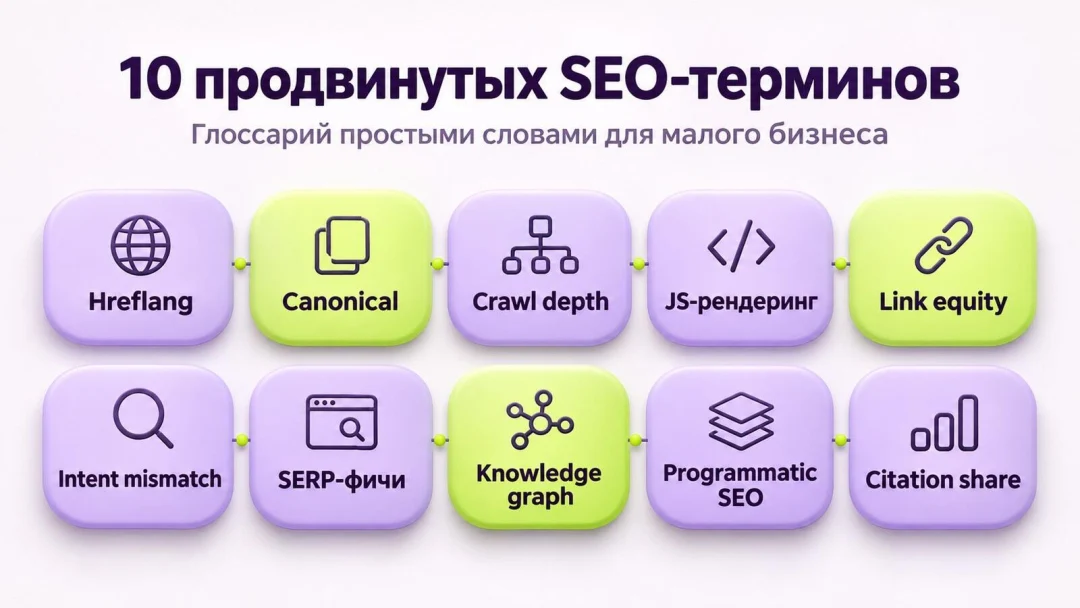
Зачем эти SEO-термины и как пользоваться глоссарием
Учить термины SEO полезно, когда отчёт, разработчик или фрилансер говорят жаргоном, который вам всё равно приходится утверждать. Общий словарь снижает дорогие недопонимания: можно спросить «это проблема глубины обхода или несовпадение интента?» вместо кивков в тумане аббревиатур.
Держите этот глоссарий SEO как справочную карточку. Прочитали термин, сверили контраст «без / с», решили, относится ли он к размеру вашего сайта. Пропускайте всё, что нужно только после мультиязычных версий, тяжёлого JavaScript или большой библиотеки шаблонов.
Клиника, магазин и сервисная бригада встречают разный жаргон в разное время. Клиника слышит про языковые версии, когда открывает испанскую запись. Магазин — про canonical, когда реклама дописывает tracking-параметры к каждому товарному URL. Сервис — про глубину обхода, когда новый блок «районы выезда» прячет телефон на три меню вниз. Глоссарий ниже удобно читать так: нашли термин, который только что услышали, остальное пропустите, пока стек этого не потребует.
Ещё одна граница: эта страница объясняет ярлыки. Она не заменяет технический аудит, контент-календарь или спринт по local pack. Когда термин указывает на более глубокую работу, идите по внутренней ссылке к статье, которой на этом сайте уже принадлежит этот угол.
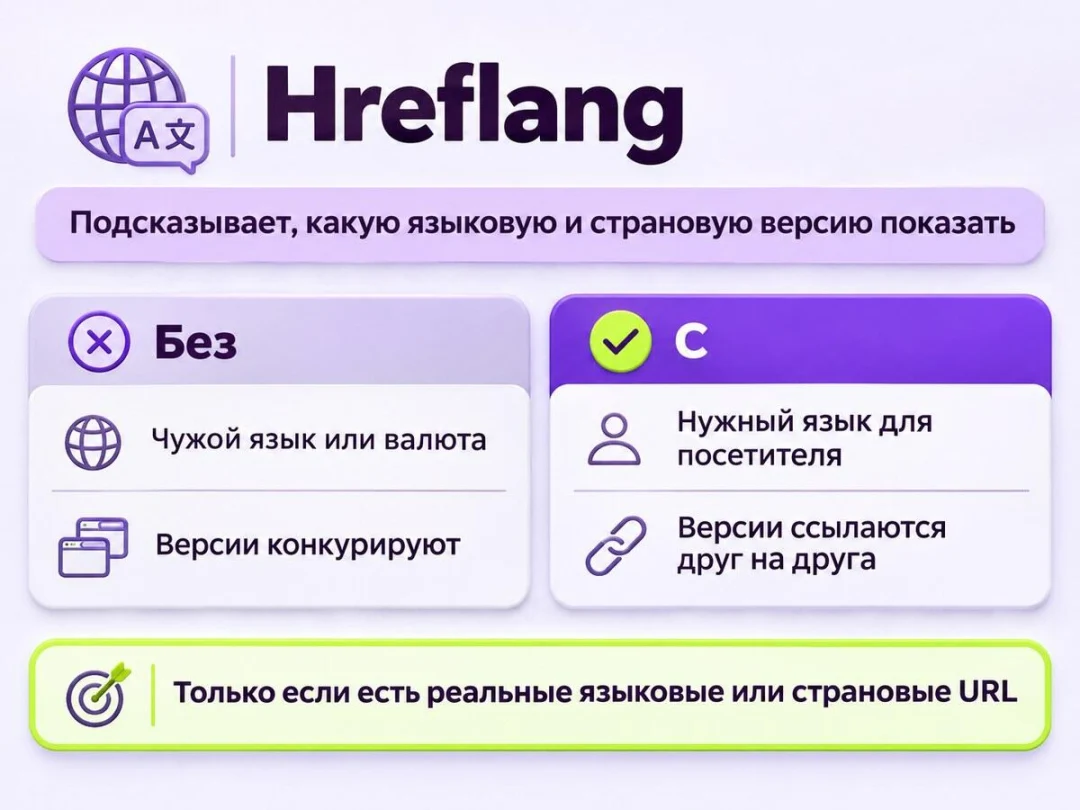
Hreflang — показывать нужный язык и страну
Hreflang (хрефланг) — набор сигналов (обычно HTML-теги link), которые подсказывают поиску, какую языковую и региональную версию страницы показать пользователю. Это вежливая этикетка: «этот URL для испаноговорящих в Мексике; тот — для испаноговорящих в Испании».
Без: У американской стоматологии есть испанское зеркало и отдельный канадский английский сайт — и в выдаче всплывает чужая валюта, формат телефона или правила записи. Языковые версии ещё и конкурируют за одни и те же запросы.
С: Каждая версия ссылается на «сестёр» (и на себя). Пациент в Мексике видит MX-цены; читатель в Испании — ES-контент. Версии усиливают друг друга, а не мешают.
Правило: Добавляйте эти теги, только если реально обслуживаете несколько языков или стран на разных URL. Один английский сайт для США в этом не нуждается — не усложняйте, пока не появится настоящее /es/ или страновое зеркало.
Canonical tag — выбрать один настоящий URL
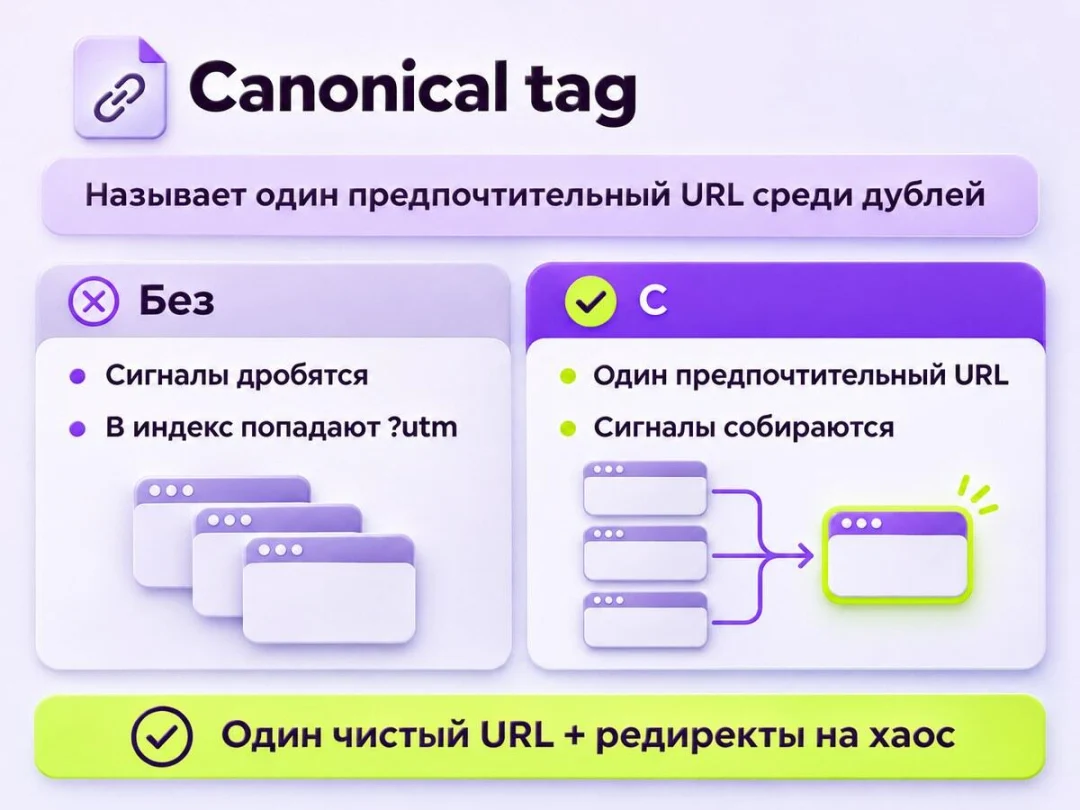
Canonical tag (канонический тег) называет предпочтительный URL, когда несколько адресов показывают одно и то же или почти одно и то же. Параметры (?utm_…, ?ref=), http против https и варианты со слэшем в конце часто плодят дубли. Тег говорит: «индексируй этот; остальные считай копиями».
Без: Поиск угадывает сам. Сигналы дробятся по вариантам, иногда в индекс попадают URL с параметрами. Отчёты шумные: одна страница видна под тремя адресами.
С: Сигналы собираются на одном каноническом URL. Аналитика и Search Console чище, потому что предпочтительный адрес назван явно.
Правило: Выберите один чистый шаблон URL на страницу, ставьте canonical на него на каждом дубле и чините очевидный хаос http/https и слэшей редиректами — не одним только тегом. Canonical это подсказка, а не замена порядку в структуре сайта.
Crawl depth — сколько кликов от главной
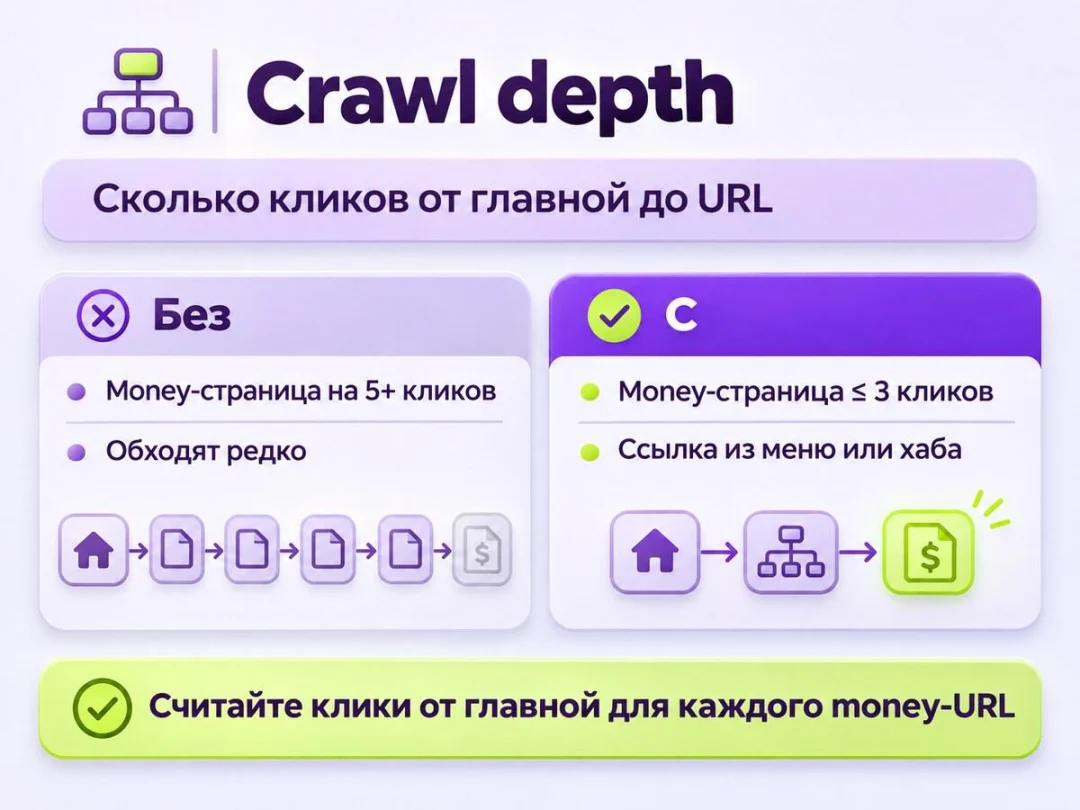
Crawl depth (глубина обхода) — сколько кликов нужно боту (или человеку), чтобы дойти до URL с главной. Неглубокие страницы находят и переобходят чаще; глубокие ждут дольше между визитами.
Без: Важные услуги или товары живут в пяти уровнях меню и ссылаются только из забытых постов. Их редко обходят, индекс обновляется медленно, и даже хороший текст недорабатывает.
С: Money-страницы лежат примерно в трёх кликах от главной, на них ведут меню, хабы категорий или понятные внутренние пути. Боты и люди находят их без квеста.
Правило: Для каждой страницы записи или покупки посчитайте клики от главной. Если четыре и больше — поднимите URL в меню, хаб или блок связанных услуг. Глубина это задача карты сайта, а не ключей.
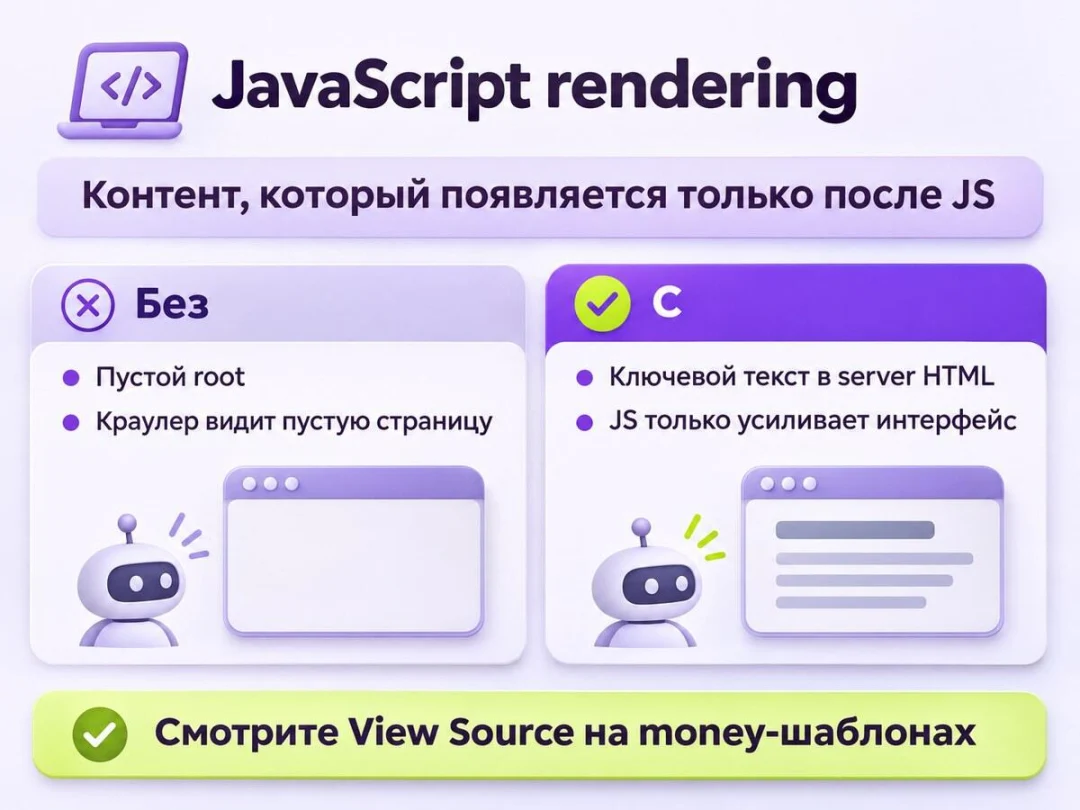
JavaScript rendering — контент, который Google (и AI-краулеры) могут не увидеть
Некоторые сайты отдают почти пустую HTML-оболочку и наполняют страницу только после того, как в браузере отработает JavaScript. Поисковым системам нужно отрисовать этот JavaScript, чтобы увидеть текст. Многие лёгкие краулеры — в том числе часть тех, что кормят AI-ответы — тяжёлый клиентский рендеринг пропускают или режут. В этом и риск JavaScript SEO для малого сайта, собранного как single-page application без серверного HTML.
Без: В исходнике «root»-блок пустой. Человек в современном браузере видит каталог; краулер — пустую страницу или спиннер. Позиции и цитирования в AI страдают, хотя дизайн вам кажется нормальным.
С: Критичные заголовки, названия товаров, цены и тексты услуг приходят уже в начальном серверном HTML. JavaScript может усиливать интерфейс, но смысл уже есть в исходнике.
Правило: Откройте «Просмотр кода страницы» (не только инспектор отрисованного DOM) на ключевом шаблоне. Если нужных клиенту слов нет в сыром HTML, попросите у разработчика server-side или пререндер, прежде чем снова платить за копирайтинг.
Link equity — «вес», который идёт по ссылкам
Link equity (вес ссылок; иногда говорят link juice) — ценность ранжирования и обнаружения, которая передаётся со страницы на страницу по ссылке. Сильные, доверенные страницы могут поддержать URL, на которые ссылаются, если ссылка обходима и не помечена nofollow (или похожим атрибутом).
Без: Самые сильные страницы (главная, популярные гайды, хорошо ссылаемый About) почти не ведут на услуги или товары, которые должны давать записи. У сантехника оживлённый гайд по авариям не ссылается на «прочистку стоков» — вес простаивает или утекает в малоценные архивы.
С: Вы сознательно ведёте со сильных страниц на money-URL с понятными естественными анкорами. Внутренние ссылки становятся маршрутизатором внимания и поддержки.
Правило: Раз в месяц откройте пять сильных страниц по ссылкам или трафику и добавьте одну полезную внутреннюю ссылку на приоритетную услугу или товар. Не путайте это с покупкой ссылок — у той задачи другой календарь.
Практическая проверка для сервиса: если главная и самый читаемый гайд оба не называют по имени три money-услуги со ссылкой, вес не доходит до страниц, которые должны отвечать на звонки.
Search intent mismatch — ранжирование не под тот тип запроса
Search intent mismatch (несовпадение с интентом) значит, что страница ранжируется (или пытается) по запросу, работу которого она не умеет закончить. Search intent — работа за запросом: узнать, сравнить, купить или записаться, найти место рядом.
Без: Тонкая категория интернет-магазина вылезает по информационному «как работает X» — люди уходят. Или блог клиники ранжируется по «запись на приём [город]» без пути записи — клики впустую.
С: Информационные запросы получают гайды; коммерческие — сравнение и доказательства; транзакционные — явный путь записи или покупки; локальные — NAP и удобные для карт страницы. Title, H1 и первый абзац совпадают с задачей.
Правило: Для каждого приоритетного URL напишите одно предложение: «Посетитель здесь должен суметь ___ меньше чем за две минуты». Если фраза не совпадает с запросом, который вы хотите выиграть, чините страницу или меняйте целевой запрос.
Владельцы часто смешивают две задачи на одном URL: длинный обучающий гайд, который ещё пытается ранжироваться по «записаться сегодня». Разделите их. Гайд оставьте честным гайдом; запросу на запись отдайте страницу, где на первом экране часы, зона и ясный следующий шаг.
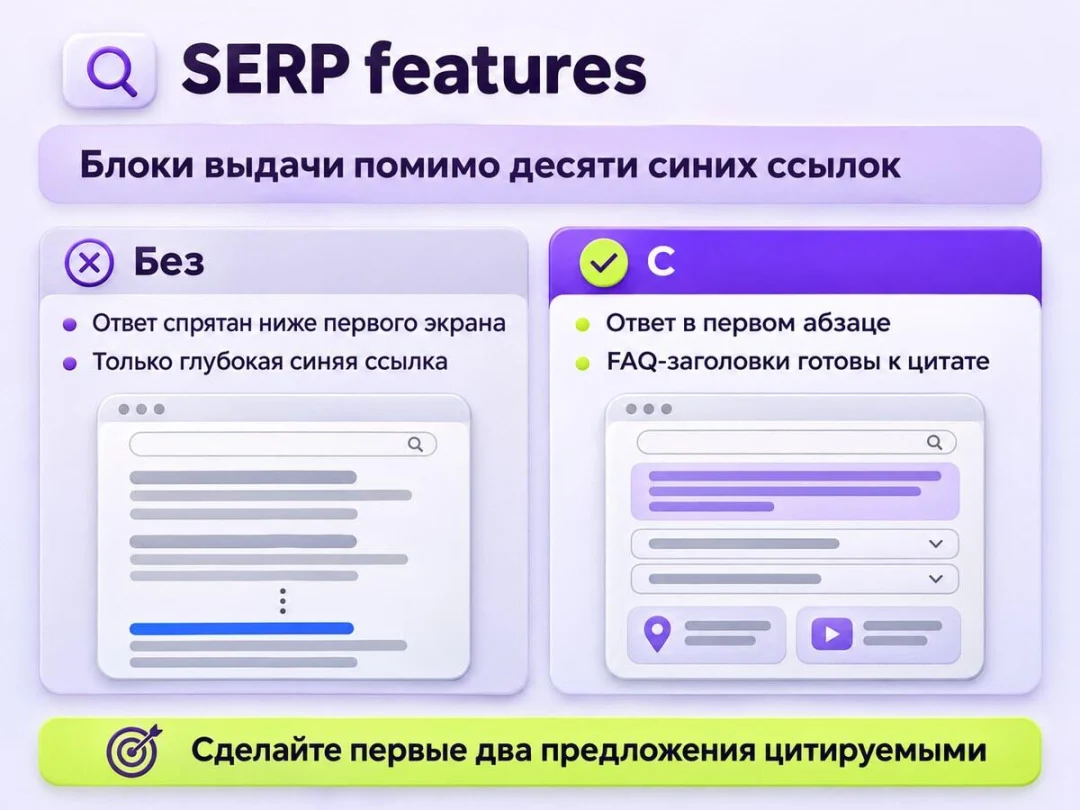
SERP features — больше, чем десять синих ссылок
SERP-фичи (элементы выдачи) — блоки на странице результатов помимо классических десяти синих ссылок: AI Overview, featured snippet, People Also Ask, local pack, видеокарусели и похожие модули. Они часто стоят выше или рядом с органикой и забирают внимание раньше первой позиции.
Без: Страница отвечает на запрос «где-то потом», ниже первого экрана. Сниппеты и AI-блоки берут более ясный ответ у конкурентов. Слоты local pack уходят тем, у кого сильнее сигналы на картах.
С: Первый абзац сразу отвечает на вопрос. FAQ-заголовки повторяют реальные уточнения. Короткое видео и ясные факты о бизнесе поддерживают модули, которые вам реально доступны. Про map pack отдельно следуйте бесплатным шагам для локального поиска, а не превращайте этот глоссарий в local-плейбук.
Правило: Перепишите начало money- и FAQ-страниц так, чтобы незнакомец мог процитировать первые два предложения как ответ. Затем добавьте честные FAQ-заголовки под вопросы, которые клиенты задают по телефону.
Knowledge graph — сущности и согласованные факты
Knowledge graph (граф знаний) — сеть сущностей (бренды, люди, места, товары) и связей между ними. Поиск опирается на согласованные факты, чтобы понять, кто вы: название, адрес, телефон, категория, основатели, те же профили в других местах.
Без: На сайте один телефон, в каталоге другой, в соцсетях другой город. Сущность размыта; расширенные результаты и сигналы доверия слабее.
С: Одни и те же опорные факты стоят на About, в подвале и в профилях. Разметка сущности организации и совпадающие ссылки sameAs помогают машинам соединить точки — без глубокого разбора schema в этой статье.
Правило: Ведите одностраничный «источник правды» по NAP, часам и юридическому имени. Все публичные профили обновляйте с этого листа. Согласованность важнее хитрой разметки на грязных фактах.
Для небольшой клиники или магазина этот лист обычно умещается на один экран: юридическое имя, отображаемое имя, адрес, телефон, часы и два–три URL профилей, которые вы реально ведёте. Когда они расходятся, машины видят несколько слабых сущностей вместо одного ясного бизнеса.
Programmatic SEO — полезные страницы масштабом (коротко)
Этот ярлык означает публикацию множества похожих страниц из шаблонов и данных (город × услуга, сетки атрибутов товара, фильтры каталога), когда каждая страница всё же помогает реальному человеку. Хорошо сделанное — честный масштаб. Плохо — doorway-спам.
Определение здесь короткое. Где такая работа стоит в приоритетах на небольшом сайте — включая, когда не плодить сотни ZIP-страниц — смотрите гайд где programmatic SEO в приоритетах. Этой странице достаточно ярлыка и предупреждения: уникальная ценность на URL или шаблон не выпускать.
Правило: Если шаблонная страница не поможет клиенту, который попал на неё случайно, не генерируйте её.
Citation share в AI-ответах — как часто модели вас упоминают
Citation share (доля цитирований в AI-ответах) — как часто ответы ИИ, в том числе AI Overview citations, называют или ссылаются на ваши страницы по сравнению с конкурентами по тем же подсказкам. Это не классический профиль бэклинков, хотя сильные страницы и ясная сущность помогают обоим.
Без: Вы никогда не смотрите, что генеративные ответы говорят о вашей категории. Гайды конкурентов цитируют каждую неделю; ваши не появляются, и вы замечаете это, только когда клиент цитирует чужой FAQ.
С: Вы ведёте фиксированный список промптов раз в неделю или две, отмечаете, кого цитируют, и закрываете пробелы в темах, где вас не видно.
Правило: Выберите десять формулировок, которыми реально спрашивают покупатели. Перепроверяйте их по расписанию. Улучшайте страницы, достойные цитаты (ясный ответ, факты, свежесть), прежде чем гнаться за тщеславными позициями, которые AI-модули игнорируют.
FAQ
Какие из этих SEO-терминов учить первыми?
Начните с search intent mismatch, глубины обхода (crawl depth) и canonical tag. Они встречаются почти на каждом малом сайте и рано чинят дорогие ошибки. Языковые теги и тяжёлый JavaScript добавляйте, только когда стек реально этого требует.
Нужен ли hreflang, если сайт только на английском в США?
Обычно нет. Теги нужны, когда вы публикуете отдельные языковые или страновые URL. Один английский сайт для одной аудитории в США может обойтись без них и без сломанных перекрёстных ссылок.
Canonical tag — это то же самое, что редирект?
Нет. Редирект переносит браузер на другой URL. Canonical оставляёт дубль доступным, но называет предпочтительную версию для индекса. Редеректом выводите настоящие дубли; canonical — когда параметры или мягкие варианты должны остаться открытыми.
Что такое search intent mismatch простыми словами?
Это когда вы показываетесь по вопросу, на который страница плохо отвечает — например, витринная страница по запросу «записаться на ремонт сегодня» без пути записи. Совместите задачу страницы с задачей запроса.
Чем citation share отличается от обычных бэклинков?
Бэклинки — ссылки на других сайтах. Метрика по AI измеряет, как часто генеративные ответы упоминают или цитируют вас по фиксированным промптам. Понятные фактические страницы помогают обоим табло, но метрики разные.
Стоит ли малому локальному бизнесу вкладываться в масштаб шаблонных страниц?
Только если есть реальная матрица полезных сочетаний (несколько услуг × несколько городов, которые вы правда обслуживаете) и уникальный контент на каждую страницу. Большинству бизнесов с одной точкой сильнее помогут хорошие страницы услуг, чем сотни тонких шаблонов. Контекст приоритетов — в статье про тактики.
Учитесь дальше, не смешивая следующие шаги
Держите эту страницу как справочник по SEO-терминам. Когда нужны приоритеты, откройте какие SEO-задачи ставить в приоритет. Когда важен map pack — бесплатные шаги для локального поиска. Когда словарь должен стать календарём — как превратить термины в план на 30 дней.
Общий SEO-глоссарий сам по себе сайт не поднимет. Он сделает честным следующий разговор с разработчиком, автором или консультантом — а это уже экономит месяцы неверной работы.